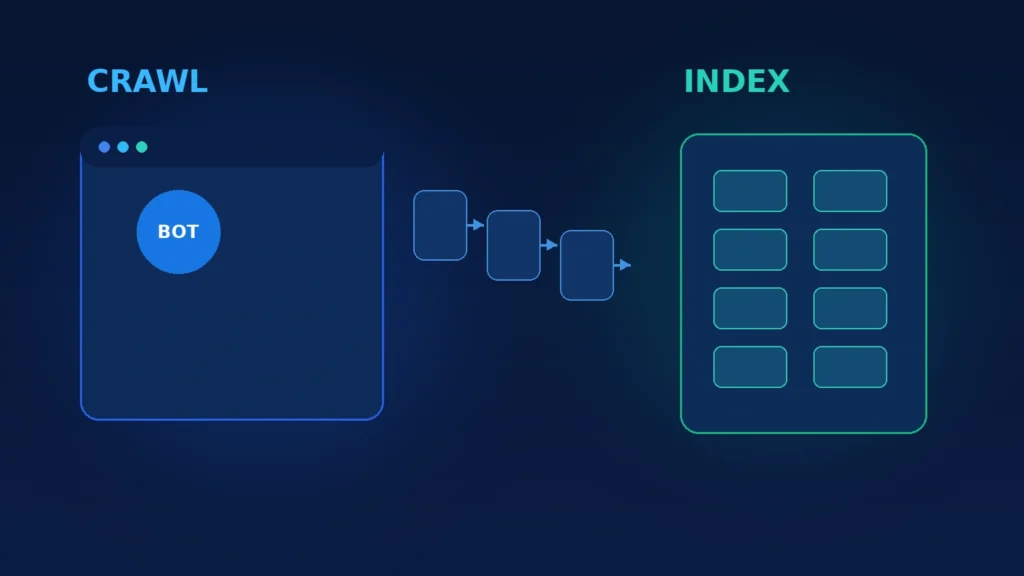
Crawl dan index sering disebut bersamaan, tetapi keduanya adalah tahap yang berbeda. Memahami perbedaannya penting karena sebuah halaman dapat ditemukan tetapi belum dirayapi, sudah dirayapi tetapi belum diindeks, atau sudah diindeks tetapi belum memperoleh ranking yang berarti.
Apa itu crawling?
Crawling adalah proses ketika crawler mesin pencari menemukan URL dan mencoba mengambil kontennya. Googlebot dapat menemukan URL melalui internal link, sitemap, redirect, atau link dari website lain. Pada tahap ini, mesin pencari berusaha mengakses halaman dan membaca resource yang dibutuhkan.
Jika server menolak bot, URL diblokir robots.txt, terjadi timeout, atau redirect berputar, proses crawling dapat terganggu. Karena itu, masalah crawl pada dasarnya berkaitan dengan kemampuan crawler menjangkau dan mengambil URL.
Apa itu indexing?
Indexing adalah tahap setelah Google memperoleh halaman dan mencoba memahami isinya. Mesin pencari menganalisis teks, title, heading, canonical, struktur, serta hubungan halaman dengan URL lain. Setelah proses ini, Google dapat memilih untuk menyimpan halaman sebagai bagian dari indeks pencarian.
Namun halaman yang sudah dirayapi tidak otomatis harus diindeks. Directive noindex, canonical menuju URL lain, konten duplikat, atau kualitas halaman dapat memengaruhi keputusan indexing.
Urutan sederhana: discover → crawl → index → rank
Untuk memudahkan diagnosis, bayangkan prosesnya sebagai empat tahap:
- Discover: Google mengetahui bahwa sebuah URL ada.
- Crawl: Googlebot mengakses dan mengambil halaman.
- Index: Google memproses halaman dan memutuskan apakah akan menyimpannya dalam indeks.
- Rank: halaman yang masuk indeks dapat dipertimbangkan untuk berbagai kueri pencarian.
Jika sebuah halaman tidak muncul, cari dulu tahap mana yang gagal. Panduan penyebab website tidak muncul di Google memberikan checklist yang lebih luas untuk pemeriksaan tersebut.
Contoh halaman gagal crawl
Misalnya Google menemukan /artikel-a/ dari sitemap. Ketika crawler mengaksesnya, server selalu memberi status 503. URL sudah ditemukan, tetapi Google belum dapat mengambil konten secara normal. Ini adalah masalah crawling.
Contoh lain adalah robots.txt yang memblokir folder tempat artikel berada. Pelajari cara kerja robots.txt agar Anda tidak mencampur fungsi crawl control dengan index control.
Contoh halaman berhasil crawl tetapi tidak diindeks
Misalnya halaman memberikan status 200 dan dapat dibaca Googlebot, tetapi memiliki meta robots noindex. Google dapat merayapinya, memahami directive tersebut, lalu tidak menyimpannya sebagai hasil yang dapat ditampilkan.
Contoh lain: halaman sangat mirip dengan URL lain dan canonical menunjuk ke versi utama. Google dapat tetap merayapi halaman duplikat, namun memilih URL lain untuk indeks.
Apa peran sitemap?
Sitemap terutama membantu discovery. Sitemap memberi daftar URL yang dianggap penting oleh pemilik website, tetapi bukan tombol “paksa index”. URL di sitemap tetap harus dapat dirayapi dan memenuhi syarat untuk diindeks.
Karena itu, sitemap yang sehat sebaiknya hanya berisi URL canonical yang memang ingin ditampilkan. Lihat panduan fungsi sitemap XML untuk memahami hubungan sitemap dengan crawl dan index.
Bagaimana mengetahui tahap masalahnya?
Gunakan data dari Google Search Console, response HTTP, source HTML, robots.txt, canonical, dan internal link. Jangan mengandalkan satu indikator saja. Sebuah URL bisa terlihat normal di browser tetapi mengirim header noindex, atau dapat diakses manusia tetapi diblokir oleh sistem keamanan untuk crawler.
Untuk pemeriksaan cepat elemen dasar halaman, Anda juga dapat menggunakan SEO Checker IDZ SEO sebagai langkah diagnosis awal, kemudian konfirmasi status indexing menggunakan alat Google yang relevan.
Crawl budget dan prioritas crawling
Pada website kecil, crawl budget biasanya bukan hal pertama yang perlu dikhawatirkan. Namun pada situs besar dengan ribuan hingga jutaan URL, duplikasi parameter, filter, kalender, pagination, dan URL berkualitas rendah dapat menghabiskan perhatian crawler pada area yang tidak penting.
Struktur internal link yang jelas, sitemap yang bersih, respons server stabil, dan pengelolaan URL duplikat membantu crawler fokus pada halaman bernilai tinggi.
Pertanyaan yang sering muncul
Apakah halaman yang sudah di-crawl pasti masuk index?
Tidak. Crawling hanya berarti mesin pencari berhasil mengambil halaman. Indexing adalah keputusan berikutnya setelah konten diproses. Halaman dapat tidak diindeks karena noindex, canonical, duplikasi, kualitas rendah, atau alasan lain.
Apakah halaman yang tidak di-crawl bisa masuk index?
Secara normal Google membutuhkan informasi tentang URL untuk memprosesnya dengan baik. Dalam beberapa situasi mesin pencari dapat mengetahui URL dari link tanpa berhasil mengambil kontennya, tetapi itu bukan kondisi yang sebaiknya diandalkan untuk SEO.
Apakah meminta indexing sama dengan meminta crawling?
Permintaan indexing dapat mendorong Google memeriksa URL, tetapi bukan jaminan URL langsung dirayapi, diindeks, atau diberi ranking tertentu. Kondisi teknis dan kualitas halaman tetap menentukan.
Kesimpulan
Crawling menjawab pertanyaan “dapatkah Google mengambil halaman ini?”, sedangkan indexing menjawab “apakah halaman ini diproses dan dipilih untuk indeks?”. Memisahkan dua konsep ini membuat diagnosis SEO jauh lebih cepat karena Anda dapat mencari penyebab pada tahap yang tepat.
URL Bisa Dirayapi tetapi Belum Tentu Diindeks
Crawling adalah proses ketika crawler mengambil resource atau halaman. Indexing adalah proses ketika mesin pencari memproses informasi dan memutuskan apakah URL layak dimasukkan ke indeks. Keduanya berkaitan tetapi tidak identik. Sebuah URL dapat ditemukan namun belum dirayapi, dapat dirayapi namun tidak diindeks, atau dapat diindeks dengan URL canonical yang berbeda.
Karena itu pemeriksaan harus mengikuti tahapnya. Jika URL belum dirayapi, cek discovery, internal link, sitemap, robots, dan respons server. Jika sudah dirayapi tetapi belum diindeks, periksa kualitas, duplikasi, canonical, rendering, noindex, dan kebutuhan pencarian.
Gunakan Search Console sebagai Bukti, Bukan Satu-satunya Sumber
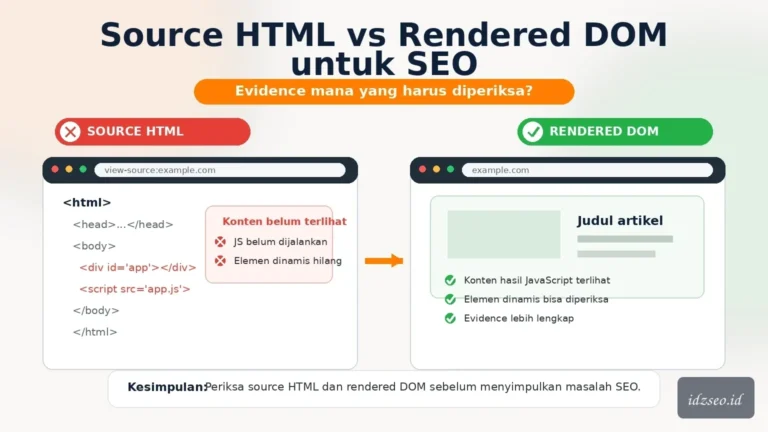
URL Inspection dapat memberi informasi status yang berguna, tetapi cocokkan dengan HTTP response dan source halaman. Pastikan status 200 memang memuat konten yang diharapkan, canonical tidak menunjuk ke URL lain secara keliru, dan robots tidak memblokir resource penting.
Untuk alur diagnosis lengkap, gunakan troubleshooting halaman tidak terindeks dan cek teknis melalui Audit SEO.
Jangan Mengirim URL Berulang sebagai Strategi
Request indexing dapat membantu pada kasus tertentu, tetapi bukan pengganti perbaikan struktur. Website yang mengandalkan submit manual untuk setiap URL biasanya memiliki masalah discovery atau prioritas konten. Bangun internal link dan sitemap yang konsisten sehingga crawler dapat menemukan perubahan secara alami.
Setelah perbaikan, beri waktu untuk recrawl dan evaluasi berdasarkan bukti baru. Indexing tidak dijamin hanya karena halaman dapat dirayapi.