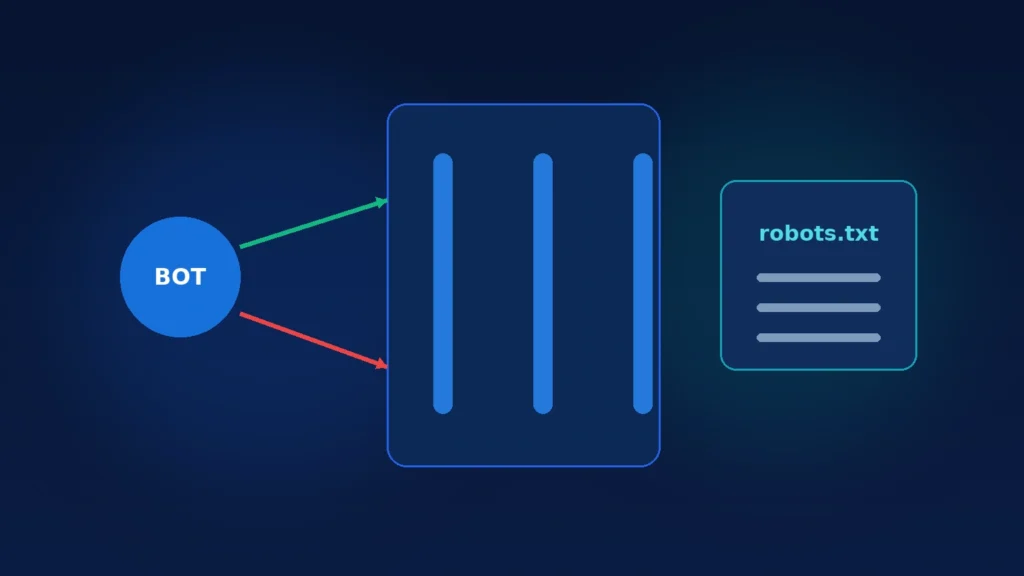
Robots.txt adalah file teks yang biasanya tersedia di root domain, misalnya https://contoh.com/robots.txt. File ini digunakan untuk memberi aturan crawling kepada crawler yang mematuhi Robots Exclusion Protocol. Dalam konteks SEO, robots.txt membantu mengelola bagian website yang boleh atau tidak perlu dirayapi.
Bagaimana struktur dasar robots.txt?
Contoh sederhana:
User-agent: *
Disallow: /admin/
Allow: /admin/ajax.php
Sitemap: https://contoh.com/sitemap.xml
User-agent menentukan bot yang dituju. Disallow menunjukkan path yang tidak diizinkan untuk dirayapi, sedangkan Allow dapat memberikan pengecualian yang lebih spesifik. Directive Sitemap dapat digunakan untuk memberi lokasi sitemap XML.
Apa fungsi robots.txt dalam SEO?
Robots.txt paling berguna untuk mengatur crawling. Contohnya, website besar mungkin memiliki area filter atau parameter yang menghasilkan sangat banyak URL yang tidak perlu dirayapi. Aturan yang tepat dapat membantu mengurangi crawling pada area tersebut.
Namun robots.txt bukan alat untuk meningkatkan ranking secara langsung. Tujuannya lebih kepada pengendalian akses crawler dan efisiensi arsitektur teknis.
Robots.txt berbeda dengan noindex
Ini adalah kesalahpahaman yang paling sering terjadi. Disallow berarti “jangan crawl URL ini”, sedangkan noindex berarti “jangan masukkan halaman ini ke indeks”. Jika sebuah URL diblokir robots.txt, crawler mungkin tidak dapat membaca meta noindex yang ada di halaman tersebut.
Karena itu, jangan mengandalkan kombinasi yang saling bertentangan tanpa memahami prosesnya. Penjelasan crawl dan index Google membantu memahami mengapa kontrol crawling dan kontrol indexing harus dipisahkan.
Bisakah URL yang diblokir robots.txt tetap muncul di Google?
Dalam kondisi tertentu, mesin pencari dapat mengetahui keberadaan URL dari link lain meskipun tidak dapat merayapi kontennya. Karena itu robots.txt bukan metode yang tepat bila tujuan Anda adalah memastikan halaman tidak muncul di hasil pencarian.
Jika masalah Anda adalah halaman penting tidak tampil, robots.txt justru termasuk salah satu hal yang harus diperiksa dalam diagnosis website tidak muncul di Google.
Contoh aturan robots.txt
Mengizinkan semua crawler
User-agent: *
Disallow:
Artinya tidak ada path yang diblokir melalui aturan tersebut.
Memblokir seluruh website
User-agent: *
Disallow: /
Aturan ini mencegah crawling seluruh domain oleh bot yang mematuhinya. Ini kadang digunakan di staging, tetapi sangat berbahaya bila ikut terbawa ke production.
Memblokir satu folder
User-agent: *
Disallow: /private/
Semua URL di bawah path tersebut diminta tidak dirayapi.
Kesalahan robots.txt yang sering terjadi
1. File staging ikut dipakai di website live
Ketika website dikembangkan, developer kadang menutup crawling dengan Disallow: /. Jika konfigurasi tersebut tidak dihapus saat launch, seluruh website dapat sulit dirayapi.
2. Memblokir CSS atau JavaScript penting
Mesin pencari dapat merender halaman untuk memahami tampilan dan konten. Memblokir resource penting tanpa alasan dapat menyulitkan rendering.
3. Menganggap robots.txt sebagai fitur keamanan
Robots.txt dapat dibaca publik dan bukan mekanisme autentikasi. Jangan menaruh URL rahasia dengan asumsi Disallow membuatnya aman. Data sensitif harus dilindungi dengan kontrol akses yang sebenarnya.
4. Menaruh noindex di robots.txt
Gunakan directive indexability yang didukung pada halaman atau header HTTP. Jangan mengandalkan sintaks yang tidak sesuai spesifikasi hanya karena pernah beredar di tutorial lama.
Hubungan robots.txt dan sitemap
Lokasi sitemap dapat dicantumkan di robots.txt agar crawler lebih mudah menemukannya. Namun sitemap tetap merupakan file terpisah dengan fungsi berbeda. Baca panduan sitemap XML untuk memahami cara keduanya bekerja bersama.
Cara memeriksa robots.txt website
Buka /robots.txt di domain Anda dan baca aturannya. Pastikan file dapat diakses, tidak mengandung blokir global yang tidak disengaja, dan tidak menutup path penting. Untuk pemeriksaan terstruktur, Anda dapat memakai Cek Robots.txt IDZ SEO.
Pertanyaan yang sering muncul
Apakah semua website wajib punya robots.txt?
Tidak selalu. Website kecil tanpa aturan khusus dapat tetap dirayapi meski file robots.txt tidak kompleks. Namun memiliki file yang benar dapat mempermudah pengelolaan crawler dan lokasi sitemap.
Apakah Disallow menghemat crawl budget?
Pada website besar, pengendalian area crawl yang tidak berguna dapat membantu crawler fokus. Pada website kecil, crawl budget biasanya bukan masalah utama; jangan membuat aturan rumit tanpa kebutuhan nyata.
Apakah robots.txt memengaruhi ranking?
Efeknya biasanya tidak langsung. Jika Anda memblokir halaman atau resource penting, mesin pencari dapat kesulitan memahami website. Tetapi menambah directive robots.txt sendiri bukan faktor ranking yang menaikkan posisi.
Kesimpulan
Robots.txt adalah alat pengendali crawling, bukan tombol untuk menghapus halaman dari Google. Gunakan aturan sesederhana mungkin, hindari memblokir area penting, dan pastikan konfigurasi production berbeda dari staging bila memang diperlukan.
Robots.txt Mengatur Crawling, Bukan Menjamin Deindexing
Rule robots.txt memberi instruksi crawler tentang URL yang boleh atau tidak boleh dirayapi. Jika URL diblokir, Google mungkin tidak dapat membaca meta robots pada halaman tersebut. Karena itu robots.txt bukan alat yang tepat untuk menjamin sebuah URL hilang dari indeks. Jika tujuan Anda adalah noindex, crawler perlu dapat mengakses halaman agar directive noindex dapat dibaca.
Jangan menggunakan robots.txt untuk canonicalization. Untuk URL duplikat, gunakan canonical atau redirect sesuai kebutuhan. Pisahkan tujuan “menghemat crawling”, “menghapus URL dari hasil”, dan “memilih URL utama” karena mekanismenya berbeda.
Uji Rule pada URL Nyata
Kesalahan pola wildcard atau path dapat memblokir area penting tanpa disengaja. Dokumentasikan user-agent dan rule yang diterapkan, lalu uji URL contoh dari setiap kelompok. Periksa juga apakah file robots.txt dapat diakses dari root host yang benar dan tidak mengembalikan respons error yang membingungkan.
Gunakan Robots.txt Checker untuk pemeriksaan awal, kemudian cocokkan hasilnya dengan tujuan indeksasi halaman.
Jaga Robots Selaras dengan Sitemap dan Internal Link
Hindari memasukkan URL yang sengaja diblokir ke sitemap sebagai URL yang Anda ingin ditemukan dan diproses. Periksa template dan navigasi agar tidak terus menautkan URL yang seharusnya tidak menjadi bagian pengalaman pengguna.
Jika masalah utama adalah halaman tidak muncul di Google, ikuti urutan diagnosis website tidak muncul di Google agar robots.txt tidak dijadikan kambing hitam sebelum bukti lain diperiksa.