Crawl budget adalah istilah yang digunakan untuk menjelaskan seberapa banyak URL pada sebuah situs yang dapat dan ingin dirayapi Googlebot dalam periode tertentu. Konsep ini sering terdengar rumit, padahal untuk sebagian besar website kecil dan menengah, crawl budget bukan masalah pertama yang harus dikejar.
Google sendiri menempatkan optimasi crawl budget terutama untuk situs yang sangat besar, memiliki banyak URL yang berubah cepat, atau menunjukkan tanda bahwa halaman penting terlambat dirayapi. Jika artikel baru Anda biasanya ditemukan dan dirayapi dalam waktu wajar, fokus yang lebih penting sering kali adalah kualitas konten, internal link, sitemap, dan kesehatan teknis dasar.
Bagaimana crawl budget terbentuk?
Secara sederhana, Googlebot tidak merayapi semua URL di internet dengan frekuensi yang sama. Sistem crawling mempertimbangkan kemampuan server menerima request dan seberapa besar kebutuhan Google untuk kembali ke URL tertentu. Karena itu, dua website dengan jumlah halaman sama dapat menerima pola crawling yang berbeda.
Sebelum membahas crawl budget lebih jauh, pahami dulu perbedaan crawl dan index Google. Crawl hanya menjelaskan proses pengambilan URL. Setelah halaman dirayapi, Google masih harus memproses dan memutuskan apakah halaman tersebut layak berada dalam indeks.
Kapan crawl budget biasanya tidak perlu dikhawatirkan?
Jika website Anda memiliki ratusan atau beberapa ribu URL yang stabil, server sehat, sitemap bersih, dan halaman baru dapat dirayapi tanpa penundaan besar, melakukan optimasi crawl budget yang agresif biasanya tidak memberikan manfaat berarti. Jangan membuat robots.txt rumit, memblokir banyak resource, atau mengubah struktur URL hanya karena istilah crawl budget terdengar penting.
Untuk website seperti blog perusahaan, situs jasa, portofolio, dan toko kecil, jauh lebih bermanfaat memastikan halaman penting mudah ditemukan melalui internal link dan tercantum pada sitemap XML yang bersih.
Kapan crawl budget mulai relevan?
Crawl budget layak diperhatikan ketika website memiliki skala besar atau menghasilkan banyak URL secara otomatis. Contohnya e-commerce dengan filter dan parameter, marketplace, forum besar, direktori, situs berita dengan pembaruan sangat cepat, atau website yang memiliki jutaan kombinasi URL.
Tanda lain adalah ketika Google membutuhkan waktu sangat lama untuk menemukan perubahan penting, crawl stats menunjukkan pola yang tidak efisien, atau sebagian besar request Googlebot justru menuju URL parameter, duplikat, redirect, error, dan area yang tidak penting.
Masalah URL yang menghabiskan crawling
Sistem filter, pencarian internal, kalender, parameter tracking, session ID, pagination yang tidak terkendali, serta kombinasi sort dapat menciptakan ruang URL yang sangat besar. Jika crawler terus menemukan variasi URL yang sebenarnya tidak memiliki nilai pencarian berbeda, kapasitas crawling dapat terbuang.
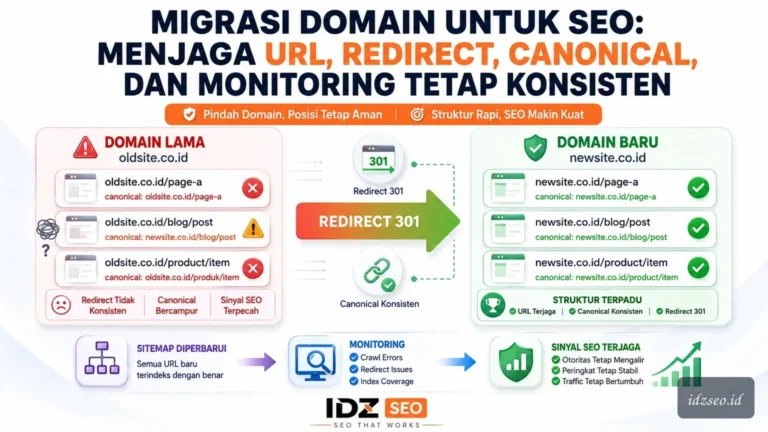
Solusinya bukan sekadar memblokir semua parameter. Pertama pahami fungsi URL tersebut. Tentukan mana yang harus menjadi canonical, mana yang tidak perlu diindeks, dan mana yang seharusnya tidak dapat ditemukan melalui link internal. Pengelolaan URL harus konsisten antara canonical, sitemap, internal link, redirect, dan robots.
Peran robots.txt dalam crawl budget
Robots.txt dapat digunakan untuk mencegah crawler mengakses area tertentu, tetapi bukan alat universal untuk membersihkan indeks. Jika URL sudah terindeks, memblokir crawling dapat membuat Google tidak bisa membaca perubahan seperti noindex pada halaman tersebut.
Gunakan robots.txt untuk area yang memang tidak perlu dirayapi, bukan untuk menyembunyikan masalah arsitektur URL. Pada situs besar, kebijakan crawl yang salah dapat membuat Google justru kesulitan mengakses halaman penting.
Server health memengaruhi crawling
Googlebot mencoba menyesuaikan crawling agar tidak membebani server secara berlebihan. Jika server sering lambat, menghasilkan 5xx, timeout, atau membatasi request secara agresif, kemampuan Google merayapi situs dapat berkurang. Karena itu, optimasi crawl budget juga berarti menjaga response server stabil.
Periksa log server dan Crawl Stats di Search Console bila tersedia. Jangan langsung menyalahkan Google ketika pola crawling menurun; pastikan hosting, firewall, CDN, rate limiting, dan sistem keamanan tidak secara tidak sengaja menghambat Googlebot.
Sitemap membantu prioritas discovery
Sitemap bukan jaminan crawling atau indexing, tetapi memberi Google daftar URL yang Anda anggap penting. Pada website besar, sitemap yang tersegmentasi dan hanya berisi URL canonical dapat membantu monitoring dan discovery.
Jangan masukkan redirect, URL 404, noindex, atau halaman duplikat ke sitemap utama. Sitemap yang penuh URL tidak valid membuat sinyal teknis kurang konsisten dan menyulitkan audit.
Internal link tetap sangat penting
Googlebot menemukan banyak URL melalui link. Halaman penting yang hanya ada di sitemap tetapi hampir tidak pernah ditautkan dari halaman lain dapat terlihat kurang terintegrasi dengan arsitektur situs. Bangun jalur internal yang logis dari halaman hub menuju halaman detail.
Untuk audit awal, Audit SEO IDZ SEO dapat membantu menemukan error response, canonical, indexability, dan pola teknis lain yang sering berkaitan dengan crawling tidak efisien.
Apakah menghapus URL meningkatkan crawl budget?
Mengurangi URL berkualitas rendah atau duplikat dapat membantu pada situs besar, tetapi jangan melakukan cleanup hanya demi angka crawl. Setiap URL harus dievaluasi berdasarkan fungsi, demand pengguna, link, dan tujuan bisnis. URL yang masih penting tidak perlu dihapus hanya karena jarang dirayapi.
Langkah audit crawl budget yang praktis
- Hitung perkiraan jumlah URL indexable dan jumlah URL yang sebenarnya ditemukan crawler.
- Periksa sitemap dan pastikan hanya URL canonical penting yang tercantum.
- Identifikasi parameter, filter, pencarian internal, kalender, dan URL duplikat.
- Periksa response 3xx, 4xx, 5xx, dan soft 404.
- Analisis log server atau Crawl Stats untuk melihat ke mana Googlebot banyak mengirim request.
- Pastikan halaman prioritas memiliki internal link yang kuat.
- Perbaiki masalah server sebelum mencoba memaksa perubahan crawl rate.
Pertanyaan yang sering muncul
Berapa angka crawl budget yang ideal?
Tidak ada angka universal. Kebutuhan setiap situs berbeda berdasarkan ukuran, perubahan konten, kesehatan server, dan demand crawling. Fokus pada apakah halaman penting dirayapi secara wajar, bukan mengejar jumlah request tertentu.
Apakah sitemap meningkatkan crawl budget?
Sitemap membantu discovery dan komunikasi URL penting, tetapi tidak otomatis menambah kapasitas crawling. Sitemap yang bersih membantu crawler menemukan prioritas Anda dengan lebih jelas.
Apakah website kecil perlu optimasi crawl budget?
Biasanya tidak sebagai prioritas utama. Jika website kecil mengalami indexing lambat, periksa dulu internal link, sitemap, noindex, canonical, kualitas halaman, dan response server.
Kesimpulan
Crawl budget menjadi penting terutama ketika skala URL besar atau crawling nyata menunjukkan ketidakefisienan. Untuk mayoritas situs, praktik terbaik adalah membuat arsitektur URL bersih, internal link kuat, sitemap akurat, server sehat, dan menghindari ruang URL tak terbatas. Jangan mengoptimasi crawl budget hanya berdasarkan teori; gunakan data crawling aktual sebagai dasar keputusan.