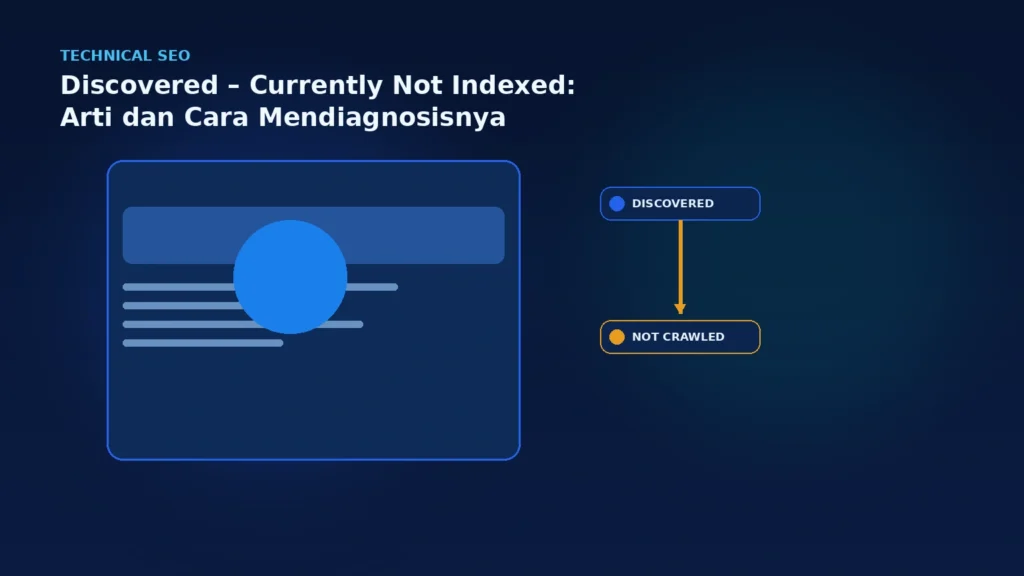
Status Discovered – currently not indexed di Google Search Console berarti Google sudah mengetahui keberadaan URL, tetapi pada saat status tersebut dicatat Google belum merayapi halaman itu. Karena belum ada crawl yang cukup untuk memproses halaman, URL tersebut juga belum berada di indeks.
Status ini berbeda dari Crawled – currently not indexed. Pada status discovered, hambatan utama berada sebelum atau pada tahap crawling. Karena itu, memperbaiki title atau menambah paragraf tidak selalu menjadi tindakan pertama yang paling relevan.
Bagaimana Google menemukan URL tanpa merayapinya?
Google dapat mengetahui URL dari sitemap, internal link, redirect, link eksternal, atau sumber discovery lain. Mengetahui URL tidak berarti crawler langsung datang. Google mengatur prioritas crawling berdasarkan banyak sinyal dan kapasitas.
Jika konsep ini masih membingungkan, baca perbedaan crawl dan index Google. Memisahkan tahap discover, crawl, index, dan rank akan membuat diagnosis jauh lebih akurat.
Apakah status ini selalu merupakan error?
Tidak. Pada URL baru, status ini dapat bersifat sementara. Google mungkin sudah mengetahui halaman tetapi belum menjadwalkan crawling. Pada situs besar, jumlah URL baru bisa jauh lebih banyak daripada URL yang layak segera dirayapi.
Masalah mulai perlu diteliti ketika banyak URL penting bertahan lama di status tersebut, khususnya jika situs menunjukkan pola URL duplikat, server lambat, internal link buruk, atau ruang crawling yang sangat besar.
Periksa apakah URL memang penting
Sebelum meminta Google merayapi semuanya, pastikan URL tersebut memang layak menjadi halaman pencarian. Halaman filter, tag kosong, pencarian internal, duplikat, atau variasi parameter mungkin tidak perlu menjadi prioritas indeks.
Jika URL merupakan artikel, produk, atau landing page penting, pastikan ia memiliki tujuan yang jelas, konten utama nyata, dan hubungan internal dengan bagian situs lain.
Audit internal link menuju halaman
URL yang hanya ada di sitemap tetapi tidak memiliki internal link kontekstual dapat terlihat seperti bagian terisolasi dari situs. Pastikan halaman penting dapat ditemukan melalui navigasi atau link dari halaman yang relevan.
Gunakan anchor yang menjelaskan konteks, bukan hanya “klik di sini”. Link internal membantu crawler menemukan URL sekaligus memahami hubungan antarhalaman.
Periksa sitemap XML
Jika URL penting, pastikan tercantum pada sitemap XML yang benar. Jangan mengirim sitemap yang berisi redirect, 404, noindex, atau URL canonical yang sebenarnya bukan versi utama.
Sitemap tidak menjamin crawl, tetapi konsistensi antara sitemap, canonical, internal link, dan status indexable membantu Google memahami URL yang benar-benar Anda prioritaskan.
Apakah crawl budget menjadi penyebab?
Pada website besar, bisa. Jika Google menemukan sangat banyak URL parameter atau duplikat, crawler dapat menghabiskan waktu di area yang kurang penting. Pelajari kapan crawl budget perlu diperhatikan sebelum membuat perubahan besar.
Pada website kecil, status discovered biasanya lebih baik dianalisis dari kualitas struktur discovery, server health, dan apakah URL benar-benar memiliki nilai unik.
Periksa server dan infrastruktur
Google dapat menunda atau mengurangi crawling jika server menunjukkan error, timeout, atau response lambat. Periksa 5xx, rate limiting, firewall, CDN, bot protection, dan kemungkinan Googlebot diblokir.
Jika banyak URL penting mengalami status discovered bersamaan dengan error server, stabilitas hosting harus diperbaiki lebih dahulu.
Jangan mengandalkan Request Indexing berulang-ulang
URL Inspection dapat digunakan untuk memeriksa halaman dan meminta indexing dalam situasi yang sesuai, tetapi mengirim permintaan berulang tidak memperbaiki penyebab struktural. Jika Google melihat ribuan URL rendah nilai, meminta satu per satu bukan strategi yang scalable.
Periksa pola, bukan satu URL saja
Kelompokkan URL berdasarkan template atau direktori. Apakah semua artikel kategori tertentu tertahan? Apakah hanya URL parameter? Apakah halaman baru dari satu template tidak memiliki internal link? Pola sering memberikan jawaban lebih cepat daripada memeriksa URL secara acak.
Audit teknis sebelum menyimpulkan masalah kualitas
Gunakan Audit SEO IDZ SEO untuk memeriksa response HTTP, canonical, robots, heading, dan sinyal teknis dasar. Pada status discovered, audit teknis berguna untuk memastikan URL memang siap ketika crawler akhirnya datang.
Checklist diagnosis
- URL memberikan response 200 ketika diakses normal.
- Tidak diblokir robots.txt.
- URL canonical menunjuk ke dirinya sendiri bila memang versi utama.
- Ada internal link dari halaman relevan.
- URL penting tercantum di sitemap.
- Server tidak sering timeout atau 5xx.
- Tidak ada pola parameter/duplikat yang menghasilkan terlalu banyak URL.
- Halaman memiliki konten utama dan intent yang jelas.
Kapan cukup menunggu?
Jika halaman baru, situs sehat, URL memiliki link internal dan sitemap, serta tidak ada error teknis, menunggu Google merayapi halaman sering kali merupakan tindakan yang wajar. Indexing bukan proses instan dan tidak semua URL ditemukan serta dirayapi pada waktu yang sama.
Kesimpulan
Discovered – currently not indexed berarti Google sudah mengetahui URL tetapi belum merayapinya. Diagnosis terbaik adalah memeriksa apakah URL benar-benar penting, mudah ditemukan, didukung internal link dan sitemap, serta server mampu melayani crawler. Pada situs besar, evaluasi crawl budget dan ruang URL; pada situs kecil, utamakan struktur, kualitas, dan kesehatan teknis sebelum mencoba trik indexing.
Kapan Harus Menunggu dan Kapan Harus Bertindak
Status Discovered – currently not indexed berarti Google mengetahui URL tetapi belum merayapinya. Itu berbeda dari URL yang sudah crawled kemudian tidak dipilih untuk indeks. Karena crawling dipengaruhi kapasitas host dan crawl demand, tidak semua URL baru akan dirayapi pada waktu yang sama. Untuk situs kecil dengan teknis sehat, beberapa URL dapat cukup menunggu tanpa intervensi agresif.
Bertindak jika pola ini menetap pada banyak URL penting. Pastikan server responsif, sitemap hanya berisi URL canonical yang ingin diindeks, dan halaman penting memperoleh internal link dari halaman yang sudah dikenal Google. Hindari membuat banyak URL bernilai rendah lalu mencoba “memaksa” semuanya melalui request indexing. Google sendiri menjelaskan bahwa crawl budget dipengaruhi kapasitas dan demand, serta tidak setiap halaman yang dirayapi akhirnya diindeks.
Bukti yang Perlu Dicatat Saat Diagnosis
Simpan tanggal pertama URL ditemukan, status sitemap, jumlah internal link menuju URL, response HTTP, robots/noindex, canonical, dan perubahan terakhir konten. Bandingkan dengan halaman sejenis yang berhasil dirayapi. Jika masalah berskala situs, audit crawl budget dan pola URL duplikat; jika hanya satu halaman, fokus pada nilai halaman dan jalur penemuannya.