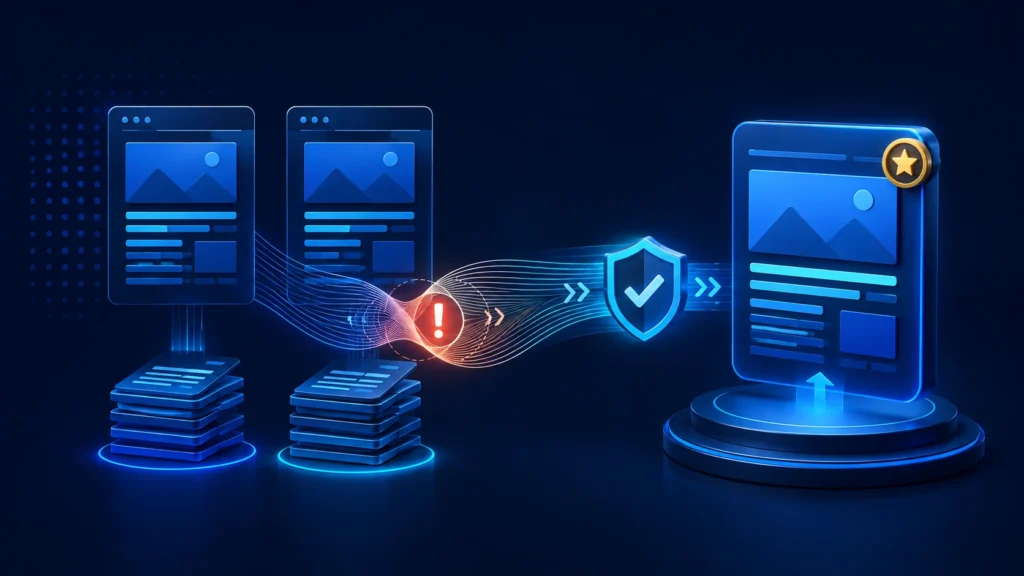
Duplicate content adalah kondisi ketika isi yang sama, nyaris sama, atau memiliki substansi yang sangat mirip dapat diakses melalui lebih dari satu URL. Masalah ini bisa muncul karena keputusan editorial, struktur teknis website, parameter URL, variasi produk, halaman lokasi, versi HTTP/HTTPS, atau sistem CMS yang menghasilkan banyak jalur menuju konten serupa.
Istilah ini sering disalahpahami sebagai “hukuman otomatis dari Google”. Dalam praktiknya, persoalan yang lebih penting adalah bagaimana mesin pencari memilih URL utama, mengalokasikan crawling, dan memahami halaman mana yang seharusnya mewakili suatu informasi. Untuk pembahasan khusus mengenai dampaknya, baca duplicate content dan SEO.
Bagaimana duplicate content bisa terbentuk?
Website modern sering menghasilkan beberapa URL untuk konten yang sama tanpa disengaja. Satu produk dapat memiliki parameter tracking, satu artikel bisa muncul melalui variasi slash, dan sistem kategori dapat membuat halaman yang isinya sangat mirip dengan arsip lain. Pada website e-commerce, filter dan sort dapat menghasilkan ratusan kombinasi URL meski konten utamanya tetap sama.
Duplicate content juga dapat muncul secara editorial. Dua penulis bisa membuat artikel dengan topik, intent, contoh, dan struktur yang hampir identik. Kondisi seperti ini tidak selalu identik secara kata per kata, tetapi tetap dapat menciptakan tumpang tindih yang perlu dievaluasi.
Duplicate content teknis vs editorial
Duplicate content teknis biasanya lahir dari sistem URL: parameter, protokol, subdomain, printer version, pagination, tracking, atau variasi path. Perbaikannya sering berkaitan dengan redirect, canonical, link internal, sitemap, atau konfigurasi CMS.
Duplicate content editorial berasal dari isi yang terlalu mirip antarhalaman. Solusinya bukan selalu canonical. Kadang dua halaman perlu digabung, dibedakan search intent-nya, atau salah satunya memang tidak perlu dipertahankan.
Apakah konten duplikat selalu buruk?
Tidak. Duplikasi tertentu normal dan tidak dapat dihindari. Kutipan spesifikasi produk, informasi legal, deskripsi singkat brand, atau versi printer bisa memiliki kemiripan tanpa otomatis menciptakan masalah besar. Yang perlu diperhatikan adalah apakah beberapa URL bersaing untuk fungsi yang sama dan apakah sinyal website menunjukkan halaman utama secara konsisten.
Hubungan duplicate content dan canonical
Ketika beberapa URL sangat mirip tetapi semuanya masih perlu dapat diakses, canonical dapat membantu menunjukkan versi yang Anda anggap utama. Namun canonical bukan alat untuk menyembunyikan arsitektur yang berantakan. Internal link, sitemap, redirect, dan URL yang dipromosikan sebaiknya tetap konsisten dengan versi utama.
Jika konsep ini belum jelas, lihat panduan apa itu canonical URL. Untuk kasus ketika Anda harus memilih antara canonical dan pemindahan permanen, baca canonical vs redirect.
Bagaimana membedakan duplicate content dengan keyword cannibalization?
Duplicate content fokus pada kemiripan isi atau representasi URL. Keyword cannibalization fokus pada beberapa halaman yang menargetkan kebutuhan pencarian yang sama sehingga kepemilikan intent menjadi tidak jelas. Dua halaman dapat mengalami cannibalization walaupun isi teksnya berbeda, dan dua URL bisa duplikat tanpa benar-benar membidik keyword yang sama.
Perbedaan ini dibahas lebih jauh pada artikel apa itu keyword cannibalization.
Cara menemukan duplicate content
Mulailah dengan inventaris URL. Crawl website dan kelompokkan URL berdasarkan title, H1, canonical, status indexability, panjang konten, serta kemiripan isi. Kemiripan exact dapat ditemukan melalui hash, sedangkan near-duplicate membutuhkan perbandingan teks yang lebih fleksibel.
Anda juga perlu membaca konteks bisnis. Dua halaman dengan 80 persen kalimat mirip belum tentu harus digabung jika melayani lokasi, produk, atau intent yang memang berbeda. Sebaliknya, dua artikel dengan kata berbeda dapat tetap bersaing jika menjawab pertanyaan yang sama.
Sinyal yang perlu diperiksa
- Apakah kedua URL indexable?
- Apakah canonical menunjuk ke dirinya sendiri atau ke URL lain?
- Apakah title dan H1 membedakan tujuan halaman?
- Apakah kedua halaman muncul di sitemap?
- Apakah internal link mengarahkan pengguna ke versi yang sama?
- Apakah Search Console menunjukkan query dan landing page yang saling tumpang tindih?
Pilihan perbaikan duplicate content
Jika dua URL benar-benar identik dan salah satunya tidak diperlukan, redirect permanen sering lebih bersih. Jika variasi URL masih harus tersedia tetapi satu versi menjadi utama, canonical dapat lebih sesuai. Jika masalahnya ada pada isi, perbaiki konten agar fungsi setiap halaman jelas atau gabungkan menjadi satu sumber yang lebih kuat.
Jangan menggunakan noindex sebagai solusi default hanya karena dua halaman mirip. Noindex mengubah indexability dan seharusnya digunakan ketika memang halaman tidak perlu berada di hasil pencarian, bukan sekadar untuk menutupi konflik struktur.
Periksa internal link dan sitemap setelah perbaikan
Setelah memilih URL utama, pastikan link internal mengarah langsung ke URL tersebut. Sitemap juga sebaiknya hanya memuat URL canonical dan indexable yang ingin Anda promosikan ke mesin pencari. Sinyal yang konsisten membantu mengurangi kebingungan antara versi lama dan versi utama.
Menggunakan alat untuk menemukan pola duplikasi
Pada website kecil, pemeriksaan beberapa halaman dapat dilakukan manual. Untuk website yang memiliki banyak URL, Duplicate Content Checker IDZ SEO dapat membantu mengelompokkan indikasi halaman yang sama atau sangat mirip sehingga Anda dapat memeriksa pasangan URL yang paling membutuhkan keputusan.
Kesimpulan
Duplicate content bukan sekadar masalah “teks sama”. Masalah utamanya adalah ketidakjelasan mengenai URL mana yang mewakili sebuah informasi dan apakah struktur website mendukung pilihan tersebut. Diagnosis yang baik membedakan duplikasi teknis, kemiripan editorial, dan cannibalization sebelum menentukan redirect, canonical, penggabungan konten, atau perbaikan struktur.